Показаны сообщения с ярлыком SQL. Показать все сообщения

среда, 19 ноября 2025 г.

DB Fiddle — бесплатная SQL песочница!

 Пока я серфила в интернете в поисках «на чем пощупать SQL», наткнулась на эту песочницу — https://www.db-fiddle.com/.

Тут фишка в том, что можно попробовать разные версии БД. Слева сверху можно выбрать СУБД и её версию:


воскресенье, 16 мая 2021 г.

Что такое База Данных (БД)

 База данных — это место для хранения данных. Используется в том числе в клиент-серверной архитектуре. Это все интернет-магазины, сайты кинотеатров или авиабилетов... Вы делаете заказ, а система сохраняет ваши данные в базе.

В этот статье я на простых примерах расскажу, что такое база данных и как она выглядит. А потом поясню некоторые термины из конкретной (реляционной) базы. Те, с которыми вы почти наверняка столкнетесь на работе.

Статья рассчитана на начинающих тестировщиков или аналитиков, то есть тех, кто будет работать с базой, но не на супер-глубоком уровне. Она для тех, кто только входит в мир ИТ, и многого не знает. Она объясняет, что это за звено в клиент-серверной архитектуре такое, и зачем оно нужно.

четверг, 6 мая 2021 г.

Требования ACID на простом языке

Мне нравятся книги из серии Head First O`Reilly — они рассказывают просто о сложном. И я стараюсь делать также.

Когда речь идёт о базах данных, могут всплыть магические слова «Требования ACID». На собеседовании или в разговоре разработчиков — не суть. В этой статье я расскажу о том, что это такое, как расшифровывается ACID и что означает каждая буква.

Требования ACID — набор требований, которые обеспечивают сохранность ваших данных. Что особенно важно для финансовых операций. Мы же не хотим остаться без денег из-за разрыва соединения или ошибки в ПО, не так ли?

См также:

Что такое транзакция

Давайте пройдемся по каждой букве ACID и посмотрим на примерах, чем архив лучше 10 разных файлов. И чем транзакция лучше 10 отдельных запросов.

Ссылка на ХАБР


Atomicity — Атомарность

Атомарность гарантирует, что каждая транзакция будет выполнена полностью или не будет выполнена совсем. Не допускаются промежуточные состояния.

Друг познается в беде, а база данных — в работе с ошибками. О, если бы всё всегда было хорошо и без ошибок! Тогда бы никакие ACID были бы не нужны. Но как только возникает ошибка, атомарность становится очень важна.

Допустим, вы решили отправить маме деньги. Когда вы делаете перевод внутри банка, что происходит:

  1. У вас деньги списались

  2. Маме поступили

И допустим, что у нас 2 отдельных запроса. А теперь посмотрим, что будет при возникновении ошибок:


понедельник, 3 мая 2021 г.

Ресурсы и инструменты для практики с базами данных | SQL (видео)


У Дениса Безтужева на канале «All about QA» вышло классное для новичков видео — «Ресурсы и инструменты для обучения и практической работы с базами данных | SQL».

О, это хорошая тема! Начинающие постоянно спрашивают, где можно потренироваться, а тут столько полезных ссылок! Сайты с уже развернутой БД для тренировки, учебники, тесты, упражнения... Рекомендую ))

И мне видео в тему, у меня есть статья «Как изучить основы SQL за 2 дня», но там примеры на тяжеловесной БД, не все могут её установить, а мне и помочь то нечем, я сама эту базу лет 10 не поднимала уже... Всё хочу переписать примеры под XAMPP сервер, но это слишком низкий приоритет, уж извините)) А теперь есть куда послать потыкать!

См также:

Изучаем SQL. Линн Бейли — книга, очень её рекомендую

SQL. Полезные запросы — моя шпаргалка

Курсы по SQL, моя подборка

воскресенье, 17 января 2021 г.

Что такое транзакция

Транзакция — это набор операций по работе с базой данных (БД), объединенных в одну атомарную пачку.

(Предполагается, что вы знаете, что такое БД. Но чуть позже тут будет ссылка на статью «что это такое»)

Транзакционные базы данных (базы, работающие через транзакции) выполняют требования ACID, которые обеспечивают безопасность данных. В том числе финансовых данных =) Поэтому разработчики их и выбирают.

Я расскажу о том, что такое транзакция. Как ее открыть, и как закрыть. И почему это важно — закрывать транзакцию. И тогда при написании запросов к базе у вас будет осознанное понимание, что происходит там, под капотом, и зачем же нужен этот обязательный коммит после апдейта.


Что такое транзакция


Транзакция — это архив для запросов к базе. Он защищает ваши данные благодаря принципу «всё, или ничего».

Представьте, что вы решили послать другу 10 файликов в мессенджере. Какие есть варианты:
  1. Кинуть каждый файлик отдельно.
  2. Сложить их в архив и отправить архив.
Вроде бы разницы особой нет. Но что, если что-то пойдет не так? Соединение оборвется на середине, сервер уйдет в ребут или просто выдаст ошибку...

В первом случае ваш друг получит 9 файлов, но не получит один.


среда, 13 января 2021 г.

SQLite на практике (курс от Антона Жиянова)


Мой коллега Антон Жиянов сделал курс по практическому применению sql в работе, очень рекомендую — https://antonz.ru/sqlite-course/.

Курс бессрочный, оплатил и делаешь хоть полгода! Ну тут кому как, кого-то мотивирует куча времени, кого-то расхолаживает )))) 

Антон отлично пишет, это можно проверить по его блогу. Прекрасные статьи, написанные просто и понятно! А еще Антон хорошо объясняет, далекие 6 лет назад именно он обучал меня на проекте )))

Так что лично я вписалась, чего и вам советую. Практики много не бывает! Wink ;)


пятница, 26 июня 2020 г.

Курсы по SQL, моя подборка

SQL сейчас требуют на собеседованиях даже от новичков. Вот они и ищут курсы. Я расскажу о трех курсах по степени возврастания цены, сложности, и количеству практики. Это курсы нашего портала и те, что рекомендовали наши выпускники в чатиках.


1. Udemy: «SQL для начинающих: с нуля до сертификата Oracle»


Ссылка — https://www.udemy.com/course/sql-oracle-certification/
Цена — 1200 руб (со скидками)

В чатике его довольная студентка порекомендовала:

Бери, там распродажи постоянные) я брала за 1200 где то) я смотрела на software здесь ещё курс, но меня привлекло на udemy количество функций, которые там изучаются) при том, на каждый оператор — своё видео, если забыл, то можно повторить) 

Если не считать бесплатных материалов, самый доступный курс.
Но учтите, что на udemy автоматизированные проверки. То есть фидбека от тренера будет мало, в основном это тесты.

среда, 28 июня 2017 г.

Найти объединенные данные (мое решение)

На прошлой неделе публиковала задачку по SQL, которая попалась мне на работе — «Найти объединенные данные». Хочу рассказать, как я ее решала.

Перед тем, как строить догадки, я посмотрела на парочку идентификаторов «вживую» и сделала вывод, что часть из них окажется неактуальными. Тогда мне казалось, что все, что от меня надо — доказать свою теорию числами. Пффф!

Но это не такая простая задачка, как оказалось. Сначала я пошла втупую — скопировала первую колонку и попробовала сделать запрос in (1, 2, 3...). Выяснилось, что внутри IN может быть только 1000 параметров, а у меня их 82 000. Облом-с.

Но ведь можно работать с таблицей! То есть главное — запихать наши 82 000 в некую темповую табличку с данными. Тут следующий облом — я умею через Workhbench, а на сервере его нету. Пошла гуглить, как без него, нашла только load data, расстроилась. Уже думала попросить админов мне файлик на сервер закинуть, как коллега услышал про мои страдания и показал, как загружать файлы через sql developer (см пункт 2).

Итак, ура, данные загрузили! Что дальше?

Подготовка тестовых данных


А что, вы думали, что я сразу понесусь тестировать на миллионах данных? Нет, конечно, сначала скрипты надо обкатать на небольшом объеме. А то так запустишь селект, который 2 часа работает, а потом поймешь, что результат невалидный, так как ты про is not null забыл, или другое условие.

Так что сначала я обратилась к своей небольшой тестовой базе и надергала оттуда разных идентификаторов, которые покрывают самые разные ситуации. Номера групп — фактически номер теста.

Сначала начала рисовать табличку, а потом поняла, что мне проще сразу в виде запросов писать тест-кейсы. А если вам интересно само задание, то вернитесь к условию и подумайте, какие тесты вы бы накидали для проверки.

ID_PARTY
GROUPING
Комментарий
3048
1
Уже объединены. Исходный 3048. Его ИД больше ИД золотого
3041
1
5162
2
Уже объединены.
Исходный 5155. Его ИД меньше ИД золотого
5155
2
...
...
...


Вот что получилось у меня:

понедельник, 26 июня 2017 г.

Как загрузить данные из файла в табличку Oracle

Допустим, входной файлик выглядит так — test.csv:

HID_PARTY;HID_EXTERNAL
11;22
15;39
...

Как загрузить эти данные в Oracle?

1. Через WBImport в Workhbench


Workhbench удобен тем, что ты один раз подготовил скрипт и все, потом можешь одним кликом догружать все новые и новые тестовые данные. Скрипт для нашего простенького файлика будет такой:

WbImport -file=test.csv
         -type=text
         -table=TMP$HID
         -encoding="UTF-8"
         -mode=insert
         -header=true
         -decode=false
         -delimiter=';'
         -fileColumns=hid_party, hid_external
         -quoteCharEscaping=none
;

Если бы в файле были колонки с датами, добавились бы еще параметры:

         -dateFormat=yyyy-MM-dd
         -timestampFormat=yyyy-MM-dd HH:mm:ss

Когда создаем новый скрипт, то все, что меняет — это

  • файл, откуда грузить;
  • таблицу, куда грузить;
  • ее колонки (простое перечисление).

2. Import Data в SQL Developer

пятница, 16 июня 2017 г.

Задачка по SQL. Найти объединенные данные

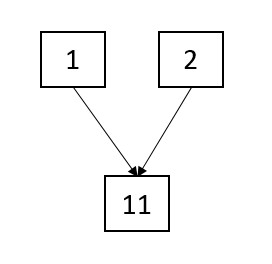
У нас можно объединять несколько карточек в одну. Вот, например, были карточки id = 1 и id = 2, которые потом объединились в id = 11.

слияние.jpg

Как это выглядит в базе данных:

1. В таблице самих карточек есть колонка Merged_status, принимает значения:
  • 0 — не объединялась никогда и не результат объединения;
  • 1 — объединена (id = 1 и id = 2)
  • 2 — результат объединения (id = 11)

id_party
Merged_status
1
1
2
1
11
2

2. Есть отдельная табличка MERGED, в которой указано, кто, в кого и когда был объединен.
  • id_party — идентификатор исходной записи, которая была объединена;
  • id_final — идентификатор результата объединения;
  • created — дата объединения;
  • cancelled — дата разъединения (не будем вникать в технические детали, просто такое может быть и тогда она будет непустой).

Для нашего случая:

id_party
id_final
created
cancelled
1
11
15.06.2017

2
11
15.06.2017


Задачка

Где-то в другой системе решили сопоставить свои идентификаторы и наши. Нашли случаи, когда клиент вроде как один в системах A, B, C, но у нас он не объединен. Выгрузили, получился csv файлик такого содержания

четверг, 16 марта 2017 г.

SQL. Полезные запросы

Это моя шпаргалка по SQL запросам, которую я постоянно использую в работе. Сохранена в простом блокнотике, пополняю по необходимости. Очень удобно, когда, например, сессия подвисла, а ты не знаешь где. Чтобы каждый раз не бегать и не гуглить "как ее найти и убить", просто открываю шпаргалочку.

А как разбить поле, выцепив только часть ДО двоеточия или наоборот, после? Я это никогда не запомню Smile :) А если ты работаешь уже на реальной, большой базе, то одна ошибка в запросе приводит к 5-10-30 минутам ожидания впустую. Не не, я лучше подсмотрю!

Итак, моя шпаргалка:


План
explain plan for select * from n_document_view ;
select * from table(dbms_xplan.display);

1. Только дата, без времени:

select distinct trunc(created, 'DDD') from folks 
where hid_party in (select * from TMP$RESULT_HIDS);

select distinct extract(year from pt_acual_date) from buffer_folks; --- только дата

2. REGEXP
WHERE REGEXP_LIKE(first_name, '^Ste(v|ph)en$')

3. Разбивка Аuthor (поле вида "AL:1")
substr(author,1,INSTR(author,':',1)-1) - до двоеточия
SUBSTR(author, INSTR(author, ':', 1)+1, LENGTH(author) - INSTR(author, ':', 1)+1) - после

substr(author, 0, instr(author, ':') - 1) — до двоеточия, source_system
substr(author, instr(author, ':') + 1) — после, external_id

вторник, 28 апреля 2015 г.

Изучаем SQL. Линн Бейли


Ссылка на OZON.

Потрясающая книга!!! Вся серия «Бестселлеры O'Reilly» — просто супер! Читается на одном дыхании, новая информация усваивается играючись. Все, как я люблю Smile :) 

Если вы ничего не знаете про SQL, но хотите узнать → обязательно прочитайте! Все просто, понятно, доступно.

Например, условие «and» внутри селекта объясняется историей: есть девочка, пусть будет Полли. Она очень хочет пончиков с глазурью. И вот она ищет по базе данных ресторанов: select name from table where type = 'с глазурью'.

Но не хочется есть жесткое или невкусное. Делаем второй select с выборкой ресторанов, у которых рейтинг более 8. И там и там результатов много, надо их вручную сопоставлять, вот пичалька то... Рисунок — сидит грустный ребенок над результатами выборок.

Но!!! Можно совместить эти два условия, написать внутри селекта "where type = xxx AND rating = yyy". И вот уже мы видим лучшие рестораны. Рисунок — девочка стоит таким ангелочком, ручки за спину, «Мааааам, а пошли в ресторан А?» Smile :)

Я знаю SQL, работаю с ним каждый день. Мне хотелось пополнить теоретическую базу, почитать подробнее о нормальных формах, например. О разных видах соединений и индексации. Я получила все, что хотела :)

В книге 600 страниц формата А4, поэтому это не быстрое чтение. Но очень увлекательное! И длительное → надо каждый пример пробовать вводить у себя на компьютере. Создавать таблички, играться с селектами. Только так информация уляжется в мозгу. Без практики — никак. Фишка серии «Бестселлеры O'Reilly» в том, что они дают практику. Ты можешь вводить конкретные примеры, чтобы набить руку. А в конце каждой главы есть упражнения для самостоятельной работы.

Когда я читала «Изучаем Java», я честно делала каждое задание, вбивала код в блокнотик. В SQL немного халтурила → писала все запросы мысленно, а потом шла читать ответ. Потому что половину книжки я уже знаю. И то после прочтения осталось такое чувство, что забыл что-то важное. Все-таки надо работать честно и честно выполнять все домашки! Smile :)

Когда закончила читать про SQL, осталось дикое желание тут же начать читать другую книжку из той же серии. Настолько они вдохновляют и воодушевляют! Если хотите изучить что-то с нуля, поищите эту тему в «Бестселлерах O'Reilly» → это идеальный старт для основ теории и начала практики!

PS - Добавила книгу в общий список прочитанных мною книг.

воскресенье, 1 марта 2015 г.

Как изучить основы SQL за 2 дня


В начале 2012 года я дорабатывала последние дни в компании ХХХ. Нас поглощал УУУ и там, на их проектах, тестировщики были не нужны. У меня было много свободного времени на работе, так как на моем проекте активность возникала раз в неделю.

Поэтому я училась. Мой разработчик начал учить меня основам программирования и рассказал про SQL, за что я ему до сих пор благодарна 😀

Он научил меня основам SQL за 2 дня. И этих знаний мне хватило, чтобы решать задачки на собеседовании. Потому что, если вы никогда не работали с SQL, все, что вам нужно знать — это основы. А чтобы понимать основы, надо просто разобраться с селектами и простейшими джойнами. Создать свою собственную базу и потыкать ее разными запросами, следя за результатами. И все! 😸

Чтобы не забыть, как это делается, я зафиксировала все познания:
Вот и всё! А если вы не можете развернуть базу из моих примеров, вот тут вы найдете кучу бесплатных ресурсов для «тык-тык».

Еще я написала себе краткую шпаргалку, которую таскала за собой по всем собеседованиям и читала, читала, читала в метро! Потому что опыта то работы нет и все теоритические познания на собеседовании испаряются. А когда за полчаса до него читаешь шпаргалку, то шансов что-то вспомнить становится больше.

Удачи на собеседованиях! 

См также:
SQL. Полезные запросы — запросы посложнее, которые я использую в работе спустя 5 лет после написания тех последних дней в компании ХХХ.

Sql-ex.ru — бесплатный тренажер для практики

PS — статья сохранена на Testbase в навыке «знать SQL», теперь не потеряется!

вторник, 20 августа 2013 г.

ORACLE. Размножение чисел добавлением к ним 10

Хочется выписать небольшой примерчик. Понимаю, что для многих он слишком простой и задачка тривиальная, но когда занимаешься скриптами целый день, к вечеру мозг выключается. Поэтому я запишу решение.

Итак - у нас есть табличка, в ней числовые данные, но тип у них VARCHAR2.
Надо их переложить в другую таблицу, а потом еще раз переложить, но добавив к значениям 10 (20, 30 - не важно), чтобы не дублировать значения.


Проверяем на маленьком объеме (модульное тестирование).

Создаем таблички

create table test (id number, data VARCHAR2(60 byte));
create table test_data (id number, data VARCHAR2(60 byte));

insert into test values (1, 1);
insert into test values (2, 2);
insert into test values (3, 3);
commit;

Проверяем, что получилось:

select * from test;
select * from test_data;

Заполняем таблицу test_data значениями таблицы test

insert into test_data (data) 
select data from test;
commit;

А теперь нам надо добавить к ним какое-то число.
Для этого мы берем строку, конвертируем ее в число, добавляем 10, а потом конвертируем обратно в строку.

insert into test_data (data) 
(select to_char(to_number(data)+10) from test);

commit;

Вот и все Smile :)

суббота, 19 мая 2012 г.

Oracle, генерация случайной даты и случайной строки

Если нам надо проверить какую-либо задачу на "а упадешь ли ты, если долго работать придется?", то надо откуда-то взять кучу данных, впоследствии отдаваемых задаче на обработку.

Создавать данные "извне" как-то уныло, клепать в каком-нибудь экселе 1 000 000 строк. Хотя, при помощи макросов, почему бы и нет?

Но если есть доступ к базе, почему бы не сделать это напрямую к ней? Итак, допустим, у нас есть таблица Авторов (В своих примерах я обычно ссылаюсь на БД с авторами книг). И нам надо сгенерировать 4 млн записей с разными ФИО и датами рождения. При этом каждые 4 автора должны быть идентичными. Как это сделать?

Генерация случайной строки.

Для того, чтобы сгенерировать случайную строку, нам необходимо использовать команду

DBMS_RANDOM.STRING (p_type, p_len)


Первый параметр, p_type, отпределяет тип генерируемой строки

Значение p_typeДействие
u
Генерировать только буквы в верхнем регистре (например,
DFTHNDSW)
l
Генерировать только буквы в нижнем регистре (например,
pikdcdsd)
aГенерировать только буквы в обоих регистрах (например, DeCW- Cass)
x
Генерировать буквы и цифры в верхнем регистре (например,
A1W56RTY)
PГенерировать любые печатные символы (например, $\$2sw&*)


Второй параметр, p_len, отпределяет длину генерируемой строки.

Мы хотим, чтобы каждая связка была уникальной, поэтому длина строки должна быть не константой, а неким значением между числом 1 и числом 2.

Итого, чтобы сгенерировать строку длиной от 3 до 5 символов в верхнем регистре, используем команду

DBMS_RANDOM.STRING ('x', DBMS_RANDOM.VALUE (3,5))

Генерация случайной даты.

Для того, чтобы сгенерировать случайную дату, возьмем команду sysdate, которая возвращает текущую системную дату и вычтем из нее какое-нибудь логичное значение.
Возьмем промежуток времени в 50 лет до текущей даты. 50 лет на 365 дней в году = 18250 дней. Запишем дату рождения автора:

  days := DBMS_RANDOM.VALUE (1, 18250);
  birth := sysdate - days;

Пример скрипта для генерации большого числа дубликатов.
Отдельные значения мы получили, теперь надо написать сам скрипт.

declare
  id number;
  days number;
  birth date;
  name nvarchar2(5);
  surname nvarchar2(10);
  patronymic nvarchar2(25);
begin
   
  for i in 1..10000000 loop
   
  days := DBMS_RANDOM.VALUE (1, 18250);
  birth := sysdate - days;
  name := DBMS_RANDOM.STRING ('x', DBMS_RANDOM.VALUE (3,5));
  surname := DBMS_RANDOM.STRING ('x', DBMS_RANDOM.VALUE (7,10));
  patronymic := DBMS_RANDOM.STRING ('x', DBMS_RANDOM.VALUE (10,25));
   
    for j in 1..4 loop
     
      select author_seq.nextval into id from dual;
           
      insert into author (ID_AUTHOR, SURNAME, NAME, PATRONYMIC, BIRTHDATE)
      values (id, surname, name, patronymic, birth);
    end loop;
     
    if mod(i, 1000) = 0 then
      commit;
    end if;
  end loop;
  commit;
end;

Вначале раздел declare - объявляем все переменные, которые будут использованы ниже.
Во внешнем цикле устанавливаем значения для ФИО и даты рождения и во внутреннем цикле вставляем их в таблицу. Для id используем команду nextval, чтобы идентификатор автора был уникальным. 

Внутренний цикл прогоняется, создав 4 одинаковых авторов, потом значения ФИО и ДР обновляется на новое рандомное значение, и так по кругу. 

ВАЖНО!!!
Отладка скрипта под свою таблицу БД осуществляется на внешнем цикле i = 5